確率密度関数とは?値が1を超える理由や確率質量関数との違いを徹底解説
統計学やデータ分析、機械学習を学び始めた人が真っ先に直面する大きな壁が「確率密度関数(Probability Density Function: PDF)」です。サイコロのように「1が出る確率は1/6」と単純に計算できる世界から、身長や気温といった連続するデータを扱う世界へ足を踏み入れた途端、「特定の一点の確率は0になる」「グラフの縦軸が1を超える」といった直感に反する現象が次々と現れるためです。
2026年現在、統計検定の対策はもちろん、AIやデータサイエンスの実務において確率モデルを正しく解釈する重要性は一段と高まっています。本記事では、数学的な本質を損なうことなく、なぜ積分と面積を使って確率を計算するのか、そして累積分布関数や確率質量関数と何が決定的に異なるのかを分かりやすく解説します。
📌 【この記事の重要ポイントまとめ】
- 要点1:確率密度関数の縦軸(高さ)は「確率そのもの」ではなく「確率の密度」であり、1を超える値をとっても数学的に全く問題ない。
- 要点2:連続型確率変数は特定の一点ピンポイントの確率が0になるため、区間の「積分(面積)」によって初めて確率が定まる。
- 要点3:離散型の「確率質量関数」や累積確率を示す「累積分布関数」との役割分担を整理することが、統計学理解の最大の近道となる。
【直感で掴む】確率密度関数とは何か?サイコロと身長の決定的な違い
確率密度関数を理解する第一歩は、変数の種類の違いを明確に区別することです。統計学で扱うデータ(確率変数)は、大きく分けて「離散型確率変数」と「連続型確率変数」の2つが存在します。
サイコロの出目やコインの表裏のように、値が「1, 2, 3...」と飛び飛びで途中の値が存在しないものを離散型確率変数と呼びます。この場合、「1が出る確率は1/6」と、特定の値に対してピンポイントで確率を割り当てることが可能です。
一方で、人間の身長、気温、移動時間のように、連続してどこまでも細かく測れる値を連続型確率変数と呼びます。ここに直感的なつまずきポイントがあります。例えば「身長が正確に170.0000...cmである確率」を計算しようとすると、分母となる候補が無限に存在するため、数学上の確率は完全に0になってしまいます。
連続的なデータでは「ある1点」の確率を定義できないため、「169.5cmから170.5cmの間に収まる確率」のように「ある幅(区間)に入る確率」として捉え直す必要があります。このとき、区間ごとの確率の詰まり具合を表現するために生み出された数式こそが確率密度関数です。
【疑問解消】なぜ確率密度は1を超えるのか?「確率」と「密度」の構造的ギャップ
初学者が最も混乱するのが、「関数の値(縦軸の高さ)を計算したら1.5や10といった1以上の数値が出てきた」というケースです。通常の確率は0以上1以下(0%〜100%)に収まるはずなのに、なぜこのような現象が起きるのでしょうか。
結論から言えば、確率密度関数の縦軸 $f(x)$ は「確率そのもの」ではなく「確率の密度(集中度合い)」を表しているからです。
身近な物理の例で考えてみましょう。体積が0.1立方メートルで重さが1kgの鉄の塊があるとします。この物体の密度を計算すると「1kg ÷ 0.1m³ = 10kg/m³」となり、数値自体は1を大きく超えます。しかし、全体の重さは1kgのまま変わりません。
確率密度関数もこれと全く同じ構造です。確率の世界における「全体の重さ」は、全区間を足し合わせた確率である「合計値=1(100%)」に固定されています。もし確率が非常に狭い範囲にギュッと集中していれば、密度を表す縦軸の高さは1を軽々と超えて2でも100でも大きくなります。
例えば、0から0.1までの範囲で一様に値をとる一様分布を考えた場合、横幅は0.1です。全体の面積を1にするためには、高さ(確率密度)は「1 ÷ 0.1 = 10」でなければなりません。縦軸の値が10であっても、横幅0.1を掛け算した「面積」は $10 \times 0.1 = 1$ となり、確率の基本ルールを満たします。
【徹底比較】確率質量関数・累積分布関数との違いを整理
統計学の学習を進める上で、名前が似通った3つの概念の混同は避けて通れません。「確率密度関数(PDF)」「確率質量関数(PMF)」「累積分布関数(CDF)」の違いを以下の比較表で整理しました。
| 比較項目 | 確率質量関数(PMF) | 確率密度関数(PDF) | 累積分布関数(CDF) |
|---|---|---|---|
| 対象とする変数 | 離散型確率変数(サイコロの目、人数など) | 連続型確率変数(身長、時間、温度など) | 離散型・連続型の両方で定義可能 |
| 縦軸 $f(x)$ の意味 | その値が出る「確率そのもの」 | その地点における「確率の密度」 | ある値以下になる「累積確率」 |
| 縦軸が1を超えるか | 絶対に超えない(最大で1) | 1を超えることがある | 絶対に超えない(0から1の範囲) |
| 特定の一点の確率 | $P(X=a) = f(a)$ で求まる | 常に $P(X=a) = 0$ | $P(X \le a) = F(a)$ で求まる |
| 全体の合計・総和 | 全パターンの合計($\sum$)が1 | 全区間の積分($\int$)面積が1 | $x \to \infty$ の極限値が1 |
| 代表的な確率分布 | 二項分布、ポアソン分布、幾何分布 | 正規分布、指数分布、t分布 | 全ての確率分布に付随して存在 |
確率質量関数は「点の確率」、確率密度関数は「幅を持った面積で確率を出すための指標」、そして累積分布関数は「マイナス無限大から特定地点まで確率を足し上げた累積値」と整理すると、頭の中の霧が一気に晴れます。
【公式と性質】期待値・分散の導出から積分計算のルールまで
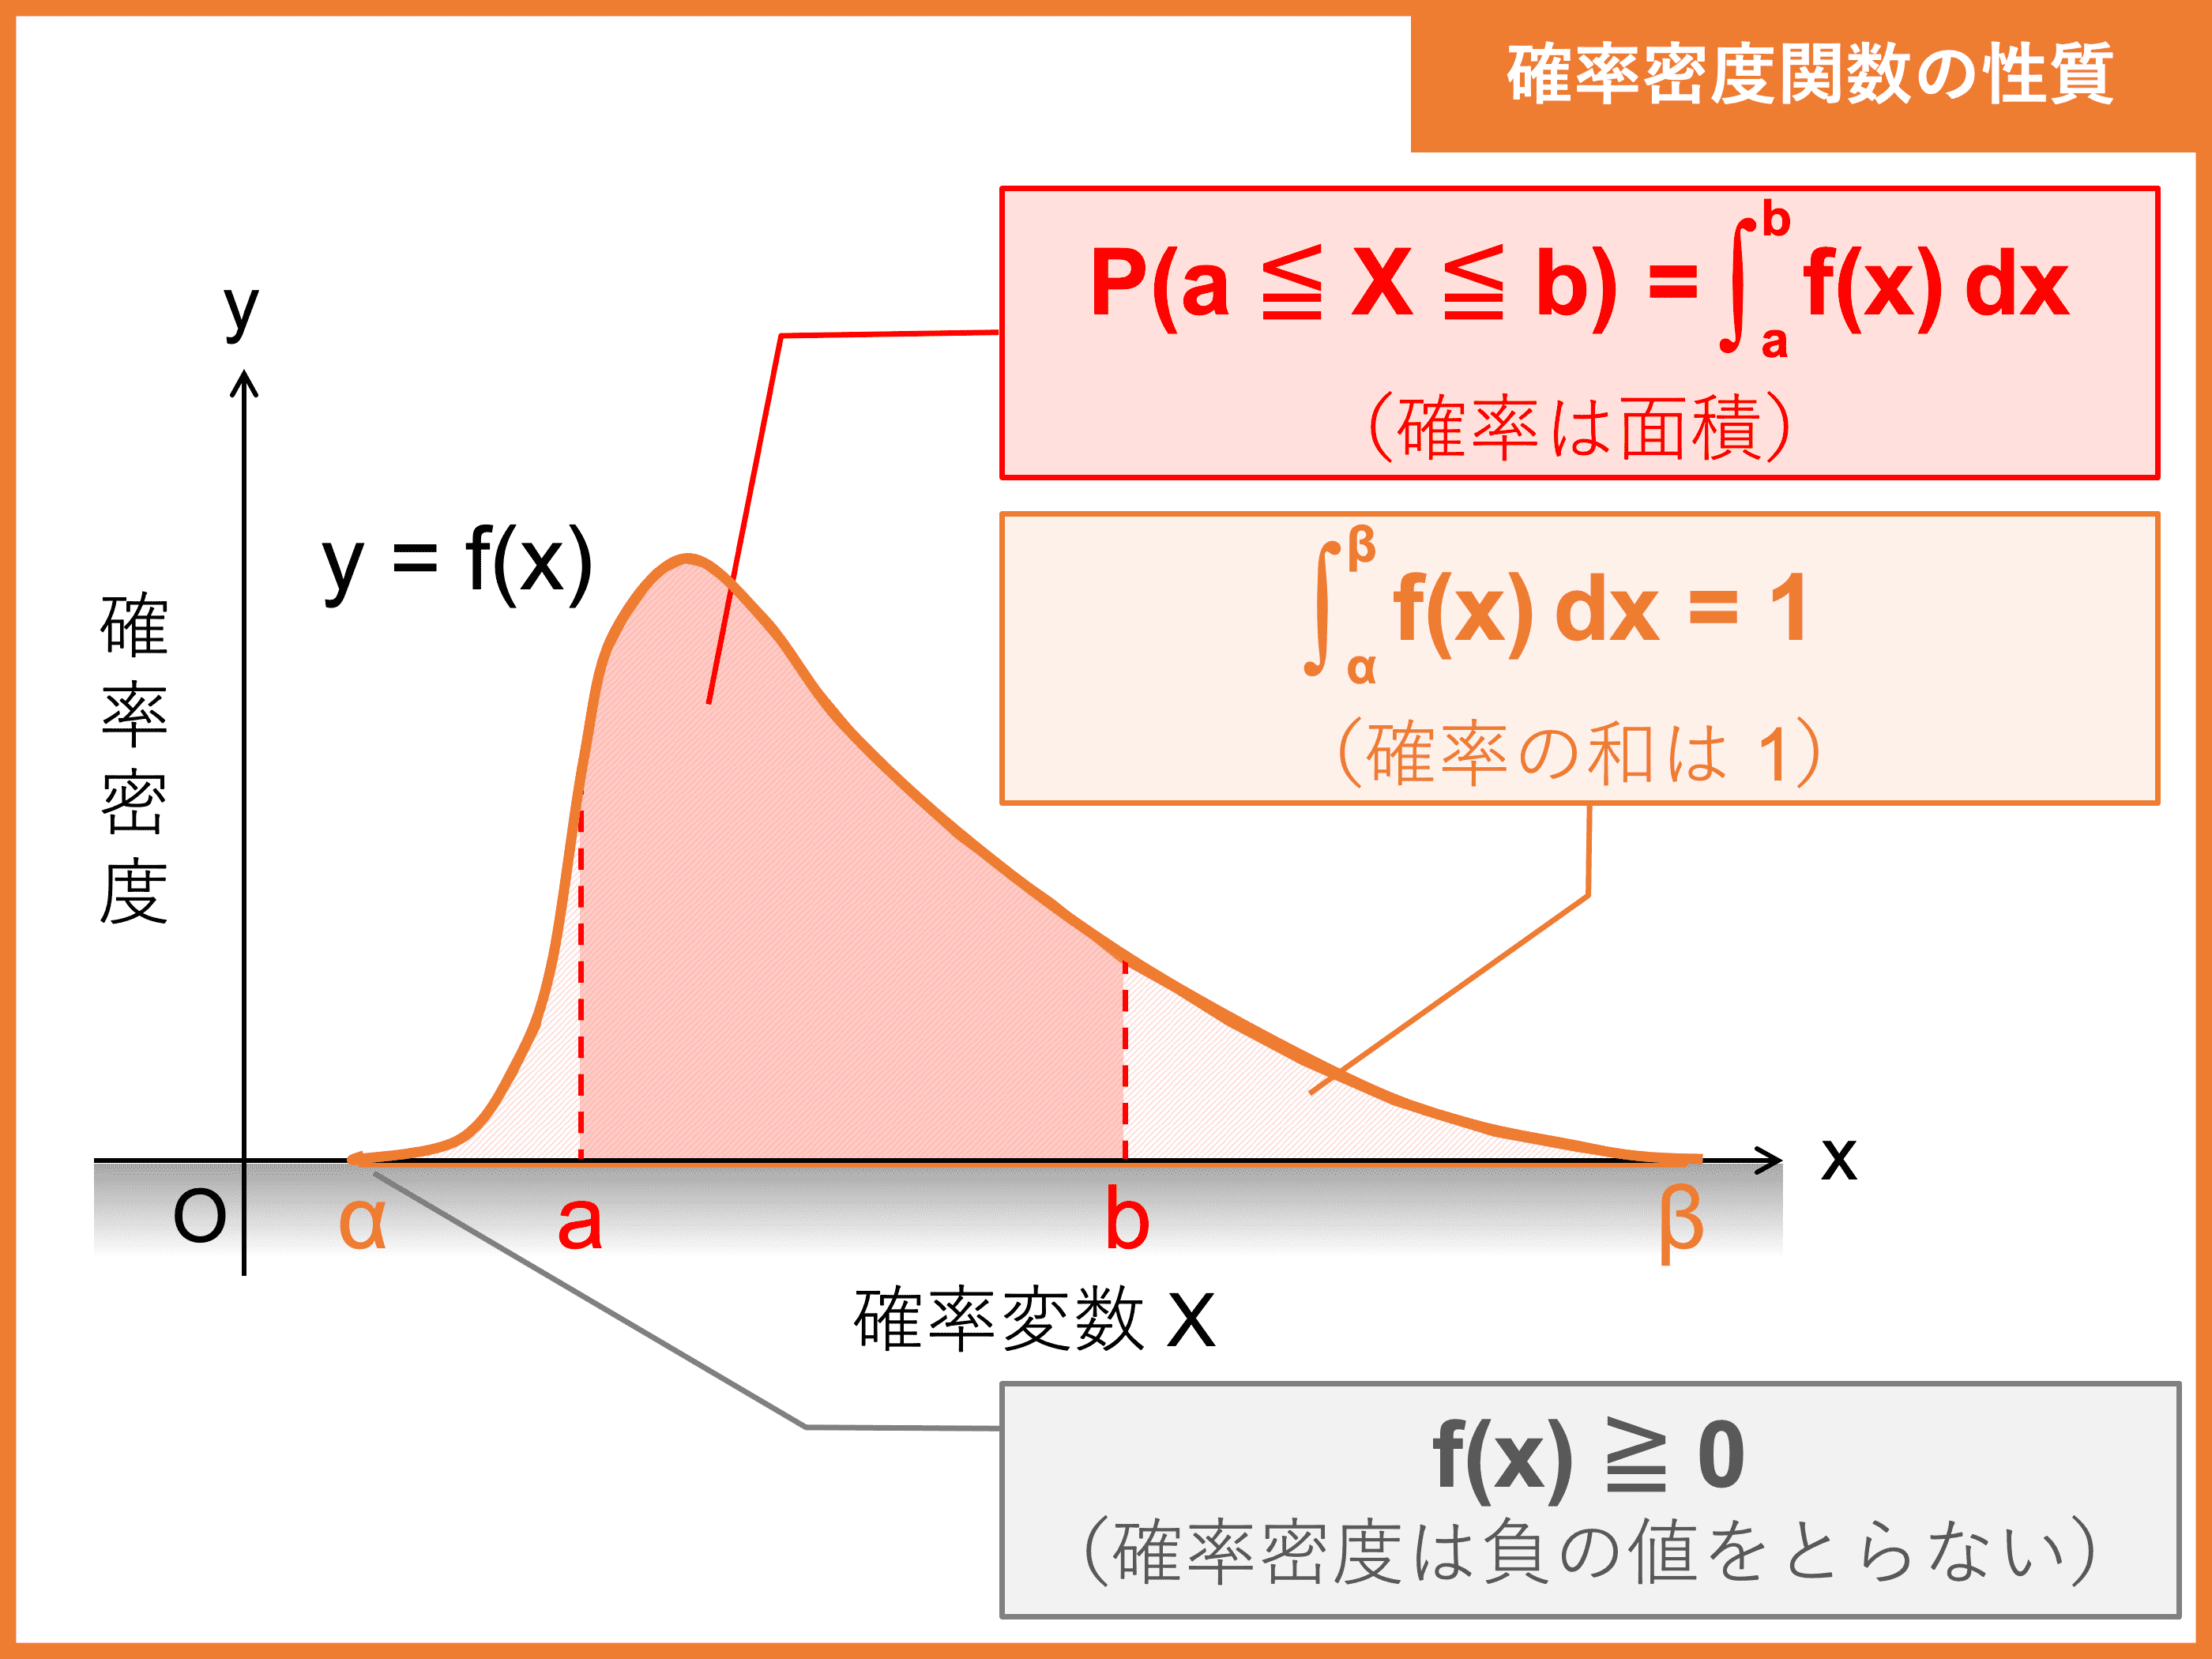
確率密度関数 $f(x)$ が満たすべき数学的な性質は、以下の2点に集約されます。
1つ目は、すべての $x$ において「$f(x) \ge 0$」であること。密度がマイナスになることはあり得ません。
2つ目は、マイナス無限大からプラス無限大まで全区間で積分した結果が「$\int_{-\infty}^{\infty} f(x) dx = 1$」になることです。グラフと横軸に挟まれた全体の面積が100%(=1)になることを意味します。
期待値と分散の計算アプローチ
連続型確率変数における期待値(平均値 $\mu$)と分散(データの散らばり $\sigma^2$)は、離散型での「値 × 確率の合計($\sum$)」を積分($\int$)に置き換えることで求められます。
- 期待値 $E[X]$: $E[X] = \int_{-\infty}^{\infty} x \cdot f(x) dx$
- 分散 $V[X]$: $V[X] = \int_{-\infty}^{\infty} (x - \mu)^2 \cdot f(x) dx = E[X^2] - (E[X])^2$
自然界や社会現象で最も頻繁に現れる正規分布(ガウス分布)の確率密度関数は釣鐘型の美しい左右対称カーブを描き、平均値の地点で確率密度が最大になります。標準正規分布(平均0、分散1)の場合、頂点の確率密度は約0.3989となりますが、標準偏差が小さくデータのばらつきが極端に狭い正規分布では、頂点の確率密度が1を余裕で突破します。
【実戦対策】統計検定で頻出の確率密度関数「例題と解法ステップ」
統計検定2級や準1級、大学の定期試験で確実に得点源にするための典型例題を確認しておきましょう。
【例題】定数の決定と区間確率の計算
確率変数 $X$ の確率密度関数が以下のように与えられているとします。
$f(x) = c x \quad (0 \le x \le 2)$、それ以外の範囲では $f(x) = 0$
問1:定数 $c$ の値を求めよ。
問2:確率 $P(1 \le X \le 2)$ を求めよ。
解法ステップ
【問1の解答】
確率密度関数の性質「全区間の積分値が1になる」を利用します。
$\int_{0}^{2} c x \, dx = \left[ \frac{c}{2} x^2 \right]_{0}^{2} = \frac{c}{2} \cdot 4 - 0 = 2c$
これが1にならなければならないため、$2c = 1 \implies \mathbf{c = \frac{1}{2}}$ と定まります。
【問2の解答】
$c = \frac{1}{2}$ を代入し、$f(x) = \frac{1}{2}x$ となります。
求める確率は、$x=1$ から $x=2$ までの区間積分(面積)を計算するだけです。
$P(1 \le X \le 2) = \int_{1}^{2} \frac{1}{2} x \, dx = \left[ \frac{1}{4} x^2 \right]_{1}^{2} = \frac{1}{4}(4) - \frac{1}{4}(1) = 1 - \frac{1}{4} = \mathbf{\frac{3}{4} \,\, (0.75)}$
このように、「全積分が1になるように定数を決める」「求めたい区間を定積分する」という2段階の手順を押さえておけば、大半の基礎問題は確実にクリアできます。
【実態検証】データサイエンス現場と初学者が直面する「3つのつまずき」
プログラミングスクールや企業内のデータサイエンス研修の現場を調査すると、受講生が確率密度関数で共通して混乱するパターンが浮かび上がってきます。
1. Python等の出力値をそのまま「確率」としてビジネス報告してしまうミス
機械学習ライブラリの `scipy.stats` やカーネル密度推定(KDE)を使って算出した $f(x)$ の値を、「この事象が起きる確率は1.4です」と誤って報告してしまう実務初心者が後を絶ちません。前述の通り、密度関数の一点出力は確率ではないため、ビジネス判断に使う際は必ず一定の区間幅を設定して累積確率や面積として算出し直す必要があります。
2. 不等号のイコール($\le$ と $<$)で過剰に悩む
「$P(X \le a)$ と $P(X < a)$ は同じなのか?」という疑問です。離散型変数(サイコロ等)では3以下と3未満で確率が変わりますが、連続型確率変数では「$X=a$ という1点の確率が0」であるため、イコールの有無で確率の計算結果は一切変わりません。この連続型特有の性質を理解していないと、無駄な迷いが生じます。
3. 累積分布関数(CDF)への変換メリットを見失う
確率密度関数のままだと確率を求めるたびに積分計算が必要になりますが、あらかじめ積分して累積分布関数 $F(x) = P(X \le x)$ を作っておけば、「$P(a \le X \le b) = F(b) - F(a)$」と単なる引き算だけで任意の区間確率が一瞬で求まります。この関数の連携プレーを理解することが実務効率化の鍵です。
【プロの結論】確率密度関数を深く学ぶべき人・概要理解で十分な人
データ分析に関わるすべての人が、数式をゴリゴリ解くレベルまで確率密度関数を極める必要があるわけではありません。目的やキャリアに応じた推奨スタンスを提示します。
数式レベルまで徹底的に学ぶべき人
- 統計検定2級・準1級以上の取得を目指す人:試験問題で確率密度の積分計算や期待値・分散の導出がダイレクトに出題されます。
- AIエンジニア・機械学習リサーチャー:変分オートエンコーダ(VAE)や拡散モデルなど、最新生成AIの根幹は確率密度の操作とサンプリング理論で構成されています。
- 金融工学・クオンツアナリスト:リスク管理やデリバティブ価格理論において、連続時間モデルの確率密度計算は必須スキルです。
直感的な概念理解(面積=確率)だけで十分な人
- ノーコードツールやBIツールを使うビジネスアナリスト:ダッシュボードのグラフを見て「データの山がどこに集中しているか」を読み取れれば実務は回ります。
- 施策の効果検証を行うマーケター:A/Bテストの有意差検定において、p値の意味さえ正しく把握していれば、背後にある確率密度の数式を手計算する必要はありません。
【確率 密度 関数 と は】に関するよくある質問(FAQ)
Q1:特定の一点 $P(X = a) = 0$ なら、その値は現実には絶対に起きないということですか?
A1:いいえ、「確率が0であること」と「事象が不可能であること」は数学的に異なります。例えば身長170.000...cmの人は現実に存在しますが、連続値の候補が無限にあるため、無限個の中からピンポイントでその1点を選ぶ確率を計算すると極限として0になります。測る側の精度の問題であり、事象自体が起きないわけではありません。
Q2:確率密度関数がマイナスの値をとることは絶対にありませんか?
A2:通常の確率論で扱う確率密度関数において、マイナスの値をとることは絶対にありません($f(x) \ge 0$)。ただし、量子力学などの極めて特殊な物理学分野では「ウィグナー疑似確率分布」のように負の値をとる擬似的な密度関数が使われる例外もありますが、データサイエンスや統計検定の範囲では「常に0以上」と覚えておけば間違いありません。
Q3:確率密度関数はどうやって作られるのですか?
A3:理論的なモデル(正規分布や指数分布など)を仮定してパラメータ(平均や分散)をデータから推定して当てはめる方法と、集めたデータのヒストグラムを滑らかにつなぐ「カーネル密度推定(KDE)」という手法を用いてデータから直接ノンパラメトリックに作成する方法の2通りが主流です。
まとめ:確率密度関数の本質を掴んでデータ分析を次のステージへ
確率密度関数は、「連続するデータの確率を面積で捉える」という発想の転換さえ身につければ、決して恐れる対象ではありません。「縦軸は確率ではなく密度」「全体の積分面積が1」「1点の確率は0で区間で考える」という3原則を頭に入れておけば、統計学の数式に対する苦手意識は大幅に軽減されます。
正規分布や一様分布をはじめとする様々な確率分布の形状と、その背後にある累積分布関数との関係性を意識しながら、データ分析や資格試験の学習を一歩ずつ進めていきましょう。 (出典: 確率 密度 関数 と は(Yahoo!ニュース))


Webメディアの編集およびコンテンツ作成に従事。正確で質の高い情報発信を心掛けています。